阅读约 3 分钟
学会说一门外语,需要掌握多少个单词?
母语者认识好几万个词,但聊天需要的远没有那么多。词汇覆盖率研究告诉我们什么,以及应该先学哪些词。
- learning-science
- vocabulary
一个以英语为母语的 20 岁美国人,平均认识大约 42,000 个词(词目),归起来约有 11,100 个词族 (Brysbaert et al., 2016)。如果你觉得开口说话之前得先翻过这座大山,那么有个好消息:想要聊天,根本用不着这么多词。日常对话里的大部分工作,都由几千个最常用的词完成。这个结论背后的研究围绕一个概念展开,叫作“覆盖率”。弄懂了它,你就知道该先学哪些词,也能判断一本书或一部剧什么时候适合你。
词和词的分量并不一样
随便数一段对话里的词,你会发现一小群词反复出现:在英语里是 the、and、I、you、go、want、good、today 这样的词。而词典里的大多数词,却很少露面。正是这种不平衡,让学习者可以进步得很快。
研究者把它量化为覆盖率:一篇文章或一段对话里,你已经认识的词所占的比例。听到的每 100 个词里你认识 95 个,覆盖率就是 95%。研究者通常也不按单个词形计数,而是按词族计数。paint、painted、painter、painting 属于同一个词族,因为认识其中一个,其他几个也很容易认出来。
研究怎么说
认识多少才算“够”?
在 Hu 和 Nation 的一项著名研究里,学习者阅读了一篇故事。故事中的一部分词被换成了编造的词,这样研究者就能精确控制有多少词是读者不认识的。覆盖率为 80% 时,没有人能充分读懂这个故事。即使到了 95%,读懂的也只是少数人。研究者估计,大多数读者要在没有帮助的情况下读懂一篇文章,需要大约 98% 的覆盖率,也就是每 50 个词里只有 1 个生词。Paul Nation 在他的综述中总结了这项研究 (Nation, 2006)。
后来的一项研究为阅读给出了两条线:最低线是 95% 覆盖率,大约需要 4,000 到 5,000 个词族;理想线是 98%,大约需要 8,000 个 (Laufer & Ravenhorst-Kalovski, 2010)。
听懂比读懂需要的词更少
接下来是让人振奋的部分。Nation 用大量真实英语语料,计算了不同类型的语言分别需要多少词族。小说和报纸要达到 98%,需要 8,000 到 9,000 个词族。日常口语需要 6,000 到 7,000 个,因为说话时更依赖最常用的那些词 (Nation, 2006)。
而且,听力可能根本不需要 98%。Hilde van Zeeland 和 Norbert Schmitt 直接研究听力时发现,大多数母语者和学习者在 90% 的覆盖率下就能充分听懂随意的口语故事,不过在这个水平上,学习者之间的差异很大。到了 95%,学习者都听得相对不错,而且彼此之间的差异小了很多。以 95% 为标准,日常听力需要 2,000 到 3,000 个词族 (van Zeeland & Schmitt, 2013)。
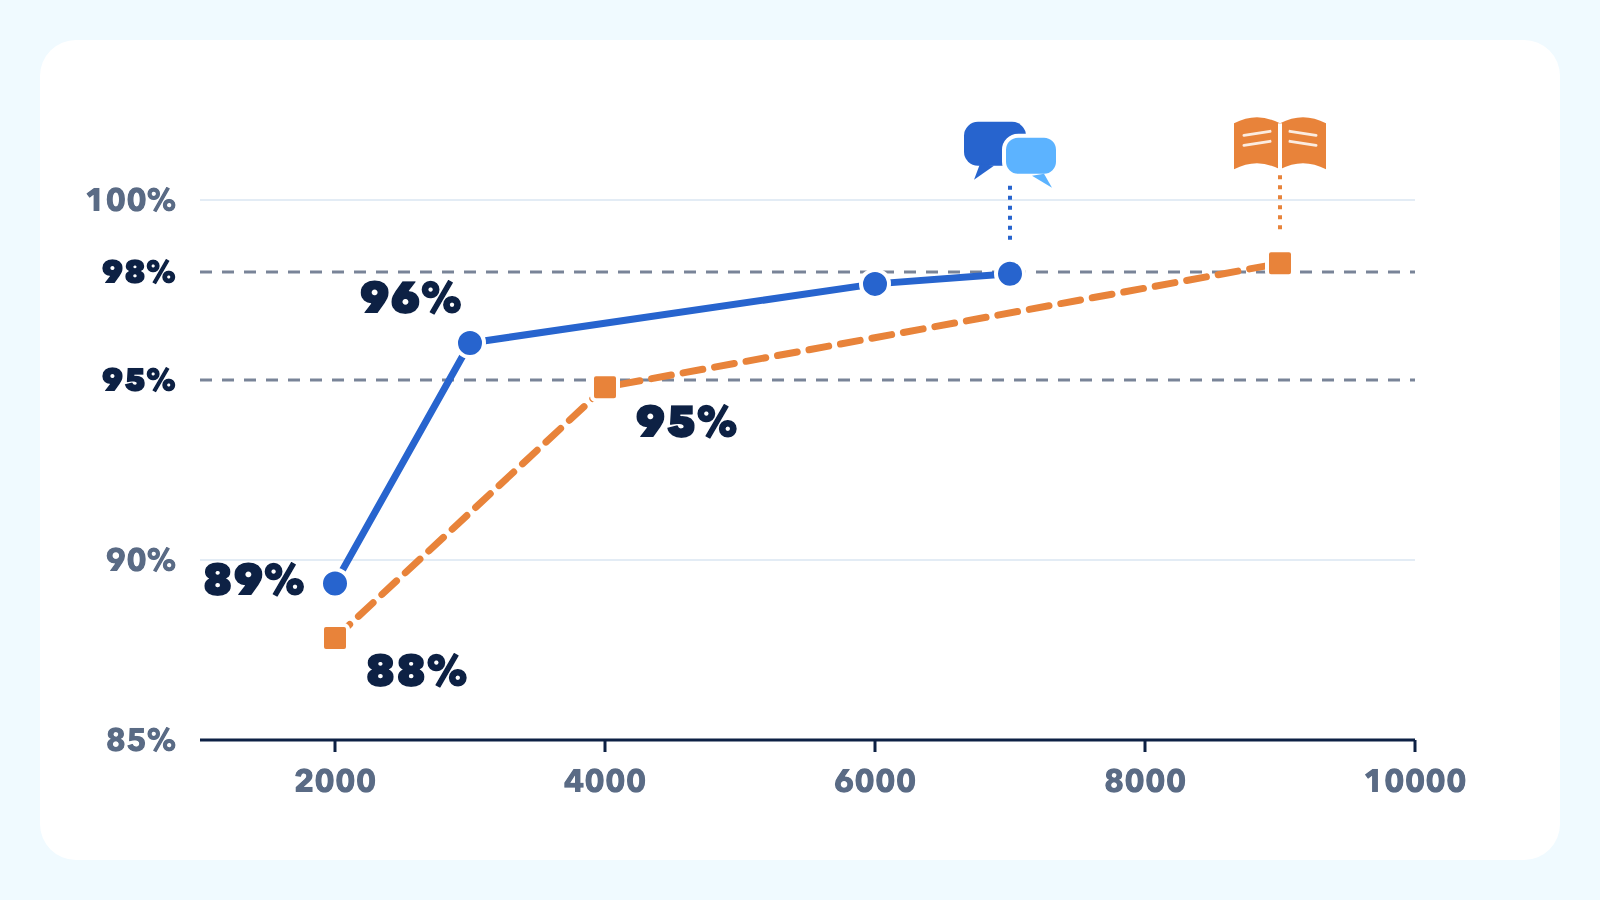
随着词汇量增长,一篇文字里你认识的词所占的比例。实线是日常对话,虚线是小说。从 3,000 个词族起(小说从 4,000 个起),人名等专有名词按已认识计算。数据:Nation (2006) 表 13 及小说合计数据。
这条曲线先陡升,然后变平。最初的 2,000 个词族就已覆盖对话的约 89%。再多 1,000 个,就超过 95%。从那以后,每多认识 1,000 个词,覆盖率增加还不到 1 个百分点。西班牙语也呈现同样的形状:在 Mark Davies 的语料库中,最常用的 1,000 个西班牙语词覆盖了口语的约 88%,前 3,000 个覆盖了 94%。之后每多 1,000 个词,带来的提升越来越小 (Davies, 2005)。
这些数字是路标,不是高墙
如果理解力正好在 95% 或 98% 时“啪”地一下打开,那就简单了,但证据表明并非如此。一项针对 8 个国家 661 名读者的研究发现,理解程度随认识的词的比例稳步上升,没有在哪个点突然跃升 (Schmitt, Jiang & Grabe, 2011)。2025 年一项重复 Hu 和 Nation 原始研究的实验发现,覆盖率为 90%、95% 和 98% 的读者在理解上没有显著差异。认识所有词的读者成绩高于 90% 和 95% 的读者,但读者之间的差异中,能用覆盖率解释的只占相当小的一部分 (Webb, Pellicer-Sánchez & Wang, 2025)。
有些估计也比乍看之下更高。一项早期研究认为 2,000 个词族几乎能覆盖全部口语,但在现代语料库中,2,000 个词族的覆盖率还不到 95%,要达到约 96%,需要大约 5,000 个单独的词 (Adolphs & Schmitt, 2003)。
所以,把这些数字当作地图,而不是及格线。每多认识一个词都会有一点帮助,越常用的词帮助越大。
今天就能用上的方法
1. 先学最常用的词
你的第一个目标,是这门语言里最常用的 2,000 到 3,000 个词族。有了它们,日常对话的大部分你都能应付。可以用词频表,或者选一门从日常用语(问候、食物、时间、地点、安排)学起的课程,而不是从“十五种水果的名字”这类冷门词汇学起。
2. 按词族学,而不是只学一个词形
学一个词时,顺便学它怎么变化。西班牙语的 hablar(说话)能带出 hablo、hablas、habló。日语的 食べる(taberu,吃)能带出 食べます(tabemasu)和 食べた(tabeta)。韩语的 먹다(meokda,吃)能带出 먹어요(meogeoyo)和 먹었어요(meogeosseoyo)。一个词族,却能让你听懂好几个词。
如果你会中文、正在学日语,很多汉字词你早就认识一半了:学生(gakusei)、電話(电话,denwa)。
3. 做个“二十分之一”测试
在开始读一本书、一篇文章或看一集剧之前,挑出大约 100 个词,数数有几个生词。5 个左右(95%),说明你借助词典、花点力气就能跟上。2 个左右(98%),说明你可以放松享受。如果有 10 个或更多,就先放一放,过几个月再来。
4. 先学主题词
每个故事都有反复出现的词。Nation 发现,儿童电影《怪物史莱克》不断重复 ogre(怪物)、swamp(沼泽)这样的词。把这几个反复出现的词算作已认识,要达到这部电影 98% 的覆盖率,就能少用大约 1,000 个词族 (Nation, 2006)。看或读一样东西之前,先查一查它的五六个关键词。这是你能找到的最划算的覆盖率。
5. 留住学过的词
见过一次就忘掉的词,不算进你的覆盖率。像间隔重复那样,间隔越拉越长地复习新词;像提取练习那样,用自测代替重读。
在 Miaru 里试试看
在 Miaru 的课程里,新词马上就会用上:把词和意思配对,用词库拼出句子,翻译,在简短的对话里一来一往。学过的词会在之后的课程和每天的复习轮里再次出现,所以它们会一直留在你的词汇里。封面上,Luffy 站在满墙的书前,手里只拿着几张卡片,而最该先学的,正是这几张。
References
- Adolphs, S., & Schmitt, N. (2003). Lexical coverage of spoken discourse. Applied Linguistics, 24(4), 425–438. https://doi.org/10.1093/applin/24.4.425
- Brysbaert, M., Stevens, M., Mandera, P., & Keuleers, E. (2016). How many words do we know? Practical estimates of vocabulary size dependent on word definition, the degree of language input and the participant's age. Frontiers in Psychology, 7, 1116. https://doi.org/10.3389/fpsyg.2016.01116
- Davies, M. (2005). Vocabulary range and text coverage: Insights from the forthcoming Routledge Frequency Dictionary of Spanish. In D. Eddington (Ed.), Selected Proceedings of the 7th Hispanic Linguistics Symposium (pp. 106–115). Cascadilla Proceedings Project. https://www.mark-davies.org/articles/davies_26.pdf
- Laufer, B., & Ravenhorst-Kalovski, G. C. (2010). Lexical threshold revisited: Lexical text coverage, learners' vocabulary size and reading comprehension. Reading in a Foreign Language, 22(1), 15–30. https://hdl.handle.net/10125/66648
- Nation, I. S. P. (2006). How large a vocabulary is needed for reading and listening? The Canadian Modern Language Review, 63(1), 59–82. https://doi.org/10.3138/cmlr.63.1.59
- Schmitt, N., Jiang, X., & Grabe, W. (2011). The percentage of words known in a text and reading comprehension. The Modern Language Journal, 95(1), 26–43. https://doi.org/10.1111/j.1540-4781.2011.01146.x
- van Zeeland, H., & Schmitt, N. (2013). Lexical coverage in L1 and L2 listening comprehension: The same or different from reading comprehension? Applied Linguistics, 34(4), 457–479. https://doi.org/10.1093/applin/ams074
- Webb, S., Pellicer-Sánchez, A., & Wang, A. (2025). Lexical coverage and reading comprehension revisited. Reading in a Foreign Language, 37(1), 1–21. https://doi.org/10.64152/10125/67517
